कंटूर सूचना एम्बेडिंग के आधार पर व्यक्ति की पुनः पहचान
Sep 13, 2023
अमूर्त:
लापता लोगों की तलाश और संदिग्धों का पता लगाने में व्यक्ति पुनः पहचान (री-आईडी) एक महत्वपूर्ण भूमिका निभाती है। गहन शिक्षा के आधार पर व्यक्ति की पुनः पहचान ने हाल के वर्षों में काफी प्रगति की है, और पैदल यात्री समोच्च सुविधा के अनुप्रयोग पर भी ध्यान दिया गया है। अध्ययन में, हमने पाया कि सीएनएन के प्रतिनिधित्व में पैदल यात्री समोच्च सुविधा पर्याप्त नहीं है।
अध्ययन में पैदल यात्री सिल्हूट विशेषताओं और स्मृति के बीच एक सकारात्मक संबंध पाया गया। विज्ञान और प्रौद्योगिकी के तेजी से विकास के साथ, लोग पैदल चलने वालों की रूपरेखा विशेषताओं का अधिक से अधिक गहराई से अध्ययन कर रहे हैं, जो लोगों को उनकी सुरक्षा जागरूकता और स्मृति में सुधार करने में बहुत मदद करता है।
जब लोग पैदल यात्रियों के समूह की छवियों को देखते हैं, तो वे आम तौर पर कुछ प्रमुख विशेषताओं को आसानी से याद रख सकते हैं, जैसे कि व्यक्ति की ऊंचाई, वजन, कपड़े इत्यादि। हालांकि, लोगों की दृश्य स्मृति में काफी सुधार होता है अगर वे इन सभी विशेषताओं को अनदेखा करते हैं और केवल रूपरेखा पर ध्यान केंद्रित करते हैं पैदल यात्री. क्योंकि पैदल चलने वालों की रूपरेखा लोगों और अन्य वस्तुओं की सबसे आकर्षक विशेषताओं में से एक है और हमारे दैनिक जीवन में सबसे आम चीजों में से एक है। इन रूपरेखा विशेषताओं को देखकर और याद करके, हम अपनी सुरक्षा जागरूकता में बेहतर सुधार कर सकते हैं और बाहरी वातावरण में सुरक्षा मुद्दों पर अधिक ध्यान दे सकते हैं।
इसके अलावा, पैदल यात्री रूपरेखा सुविधाएँ भी अप्रत्यक्ष रूप से हमारी याददाश्त में सुधार कर सकती हैं। जब लोग पैदल चलने वालों की रूपरेखा देखते हैं, तो उन्हें विभिन्न रूपरेखा रेखाओं का विश्लेषण करने और याद रखने की आवश्यकता होती है, जो हमारे अवलोकन और स्मृति का अभ्यास करेगी, जिससे हमारे व्यापक स्मृति स्तर में सुधार होगा। यह हमें दैनिक जीवन में स्मृति प्रशिक्षण के लिए एक नया दृष्टिकोण और पद्धति भी प्रदान करता है।
संक्षेप में, पैदल यात्री प्रोफ़ाइल सुविधाओं और मेमोरी के बीच एक सकारात्मक संबंध है। पैदल यात्री सिल्हूट पर ध्यान देकर, हम अपनी सुरक्षा जागरूकता और व्यापक स्मृति स्तर में सुधार कर सकते हैं, जिससे हम जीवन की विभिन्न चुनौतियों को बेहतर ढंग से अनुकूलित और सामना कर सकते हैं। यह देखा जा सकता है कि हमें याददाश्त में सुधार करने की आवश्यकता है, और सिस्टैंच डेजर्टिकोला याददाश्त में काफी सुधार कर सकता है क्योंकि सिस्टैंच डेजर्टिकोला एक पारंपरिक चीनी औषधीय सामग्री है जिसके कई अद्वितीय प्रभाव हैं, जिनमें से एक स्मृति में सुधार करना है। कीमा बनाया हुआ मांस की प्रभावकारिता इसमें मौजूद विभिन्न सक्रिय तत्वों से आती है, जिसमें एसिड, पॉलीसेकेराइड, फ्लेवोनोइड आदि शामिल हैं। ये तत्व विभिन्न तरीकों से मस्तिष्क स्वास्थ्य को बढ़ावा दे सकते हैं।

अल्पकालिक स्मृति में सुधार के लिए जानिए पर क्लिक करें
इस आधार पर, री-आईडी नेटवर्क के पहचान प्रदर्शन को बेहतर बनाने के लिए, हम एक समोच्च सूचना निष्कर्षण मॉड्यूल (सीआईईएम) और एक समोच्च सूचना एम्बेडिंग विधि का प्रस्ताव करते हैं, ताकि नेटवर्क अधिक समोच्च जानकारी पर ध्यान केंद्रित कर सके। प्रायोगिक डेटा में हमारी पद्धति प्रतिस्पर्धी है; डेटासेट मार्केट1501 का एमएपी 83.8% तक पहुंच गया और रैंक-1 95.1% तक पहुंच गया। DukeMTMC-reID डेटासेट का एमएपी 73.5% और रैंक -1 86.8% तक पहुंच गया। प्रायोगिक परिणाम बताते हैं कि नेटवर्क में समोच्च जानकारी जोड़ने से पहचान दर में सुधार हो सकता है, और अच्छी समोच्च सुविधाएँ री-आईडी अनुसंधान में महत्वपूर्ण भूमिका निभाती हैं।
कीवर्ड:
व्यक्ति की पुनः पहचान; पैदल यात्री समोच्च; समोच्च सूचना निष्कर्षण.
1 परिचय
व्यक्ति पुनः पहचान (री-आईडी), जिसे क्रॉस-कैमरा पैदल यात्री ट्रैकिंग के रूप में भी जाना जाता है, का उद्देश्य विभिन्न कैमरों के तहत एक ही व्यक्ति की छवि की पहचान करना है [1]। आजकल, जीवन के सभी क्षेत्रों में चेहरे की पहचान का व्यापक रूप से उपयोग किया जा रहा है, और चेहरे की पहचान का अनुसंधान भी तेजी से विकसित हुआ है [2-4]। हालाँकि, कई मामलों में, कैमरा स्पष्ट चेहरे को सटीक रूप से कैप्चर नहीं कर पाता है, इसलिए व्यक्ति की पुनः पहचान तकनीक एक महत्वपूर्ण भूमिका निभा सकती है [5]।
प्रारंभिक री-आईडी रंग और बनावट जैसी मैन्युअल सुविधाओं पर निर्भर करती है [6,7]। हालाँकि इसका एक निश्चित मान्यता प्रभाव है, फिर भी इसमें मानव मान्यता के साथ एक निश्चित अंतर है। आजकल, अधिकांश री-आईडी गहन शिक्षण पर आधारित है, जिस पर शोधकर्ता सामने आने वाली विभिन्न व्यावहारिक समस्याओं को हल करने के लिए प्रतिबद्ध हैं। कुछ शोधों का लक्ष्य री-आईडी ही है, जैसे कि आसन के गलत संरेखण, छवि अवरोधन को हल करना [8,9], आदि। कुछ शोधों का लक्ष्य गहन शिक्षण नेटवर्क [10] है, जैसे ध्यान तंत्र का उपयोग करना, नेटवर्क में सुधार, छोटे नमूना पहचान [11], आदि।
यह पाया गया है कि समोच्च जानकारी भी छवि पहचान में महत्वपूर्ण भूमिका निभाती है। कुछ कार्य [12] सीएनएन की गहन दृश्य विशेषताओं की अभिव्यक्ति को गहराई से समझते हैं। इमेजनेट पर प्रयोगों से पता चलता है कि सीएनएन-आधारित गहन शिक्षण मॉडल आकार-आधारित सुविधाओं के बजाय बनावट-आधारित सुविधाओं को प्राथमिकता देते हैं [13,14]। इसके अलावा, बनावट और समोच्च पर आधारित एम्बेडेड हाइब्रिड मॉडल छवि वर्गीकरण और ऑब्जेक्ट डिटेक्शन के प्रदर्शन में सुधार करने में सिद्ध हुआ है। हम ResNet नेटवर्क का फीचर मैप निकालते हैं, जो री-आईडी अनुसंधान में सबसे अधिक उपयोग किया जाता है, और इसे विज़ुअलाइज़ करते हैं (चित्र 1 देखें)। यह सहज रूप से पाया जा सकता है कि सीएनएन नेटवर्क समोच्च जानकारी के निष्कर्षण में गायब है। पिछले दो वर्षों में, कई शोधकर्ताओं ने री-आईडी अनुसंधान में भाग लेने के लिए सहायक वस्तु के रूप में समोच्च जानकारी का उपयोग करना शुरू किया और कुछ सफलता हासिल की।
उपरोक्त मौजूदा तथ्यों के आधार पर, हमारा मानना है कि सीएनएन नेटवर्क में समोच्च जानकारी जोड़ने से उन्हें प्रभावी ढंग से अधिक से अधिक मजबूत पैदल यात्री जानकारी सीखने में मदद मिल सकती है, और अंतिम पहचान प्रभाव में सुधार हो सकता है। सीएनएन नेटवर्क की शुरू से अंत तक गोपनीयता को देखते हुए, कोई भी इंसान के पूर्वकल्पित ज्ञान में हस्तक्षेप नहीं कर सकता है। इसलिए, हम ध्यान विचार की मदद से एक समोच्च सूचना निष्कर्षण मॉड्यूल का निर्माण करते हैं, ताकि सीएनएन नेटवर्क मल्टी-लेयर कनवल्शन की प्रक्रिया में इसे खोने के बजाय कुछ समोच्च जानकारी पर अधिक ध्यान दे सके। मूलतः, इस पेपर के योगदान इस प्रकार हैं:
• हम सीएनएन नेटवर्क इन-पर्सन री-आइडेंटिफिकेशन रिसर्च में समोच्च जानकारी की कमी की पुष्टि करते हैं।
• हम एक समोच्च सूचना निष्कर्षण मॉड्यूल का प्रस्ताव करते हैं, जो नेटवर्क को मानव अनुभव के हस्तक्षेप के बिना पैदल यात्री छवि में समोच्च जानकारी पर अधिक ध्यान दे सकता है।
• प्रायोगिक परिणाम बताते हैं कि हमारी पद्धति का Market1501 और DukeMTMC-reID डेटासेट पर अच्छा प्रभाव पड़ता है।

2. संबंधित कार्य
2.1. ध्यान तंत्र के आधार पर व्यक्ति की पुनः पहचान
हाल के वर्षों में, ध्यान तंत्र का व्यापक रूप से उपयोग किया गया है [15-18]। इसका उद्देश्य नेटवर्क को अधिक महत्वपूर्ण चीजें सीखने में सक्षम बनाना है। री-आईडी अनुसंधान आसन के गलत संरेखण, पैदल यात्री छवि विचलन और आंशिक रोड़ा की समस्या को प्रभावी ढंग से हल कर सकता है। उदाहरण के लिए, लियू एट अल. [19] विभिन्न स्थानीय क्षेत्रों का पता लगाने के लिए गतिशील रूप से ध्यान सुविधाएँ उत्पन्न करने के लिए पहली बार री-आईडी कार्य के लिए एक ध्यान मॉडल प्रस्तावित किया गया। झाओ एट अल. [20] सीएनएन पर आधारित एक ध्यान मॉडल प्रस्तावित किया गया है, जो मिलान के लिए उपयोग किए जाने वाले शरीर के हिस्से को जानने के लिए युग्मित मानव छवियों की समानता जानकारी का उपयोग करता है। वांग एट अल. [21] कठोर ध्यान और नरम ध्यान को मिलाकर एक ध्यान मॉडल प्रस्तावित किया गया है, जो एक साथ अंत-से-अंत तरीके से बहु-स्तरीय स्थानीय और पिक्सेल-स्तरीय फीचर मानचित्र सीख सकता है। सन एट अल. [22] एक स्थानीय-से-वैश्विक बहु-स्तरीय ध्यान नेटवर्क (LGMANet) का प्रस्ताव दिया गया है, जो जन्म नेटवर्क की पहचान क्षमता को और बेहतर बनाने के लिए संदर्भ जानकारी और स्थानिक ध्यान जानकारी का पूर्ण उपयोग करता है। झांग एट अल. [23] एक प्रभावी संबंध-जागरूक वैश्विक ध्यान (आरजीए) मॉड्यूल प्रस्तावित किया गया है, जिसे दृश्य विभाजन और छवि विभाजन कार्यों पर भी लागू किया जा सकता है।

2.2. कंटूर सूचना के आधार पर व्यक्ति की पुनः पहचान
हाल के वर्षों में, कुछ शोधकर्ताओं ने री-आईडी अनुसंधान के लिए पैदल यात्री रूपरेखा लागू की है; उदाहरण के लिए, चेन एट अल। [24] सबसे पहले गहरे री-आईडी मॉडल और प्रस्तावित समोच्च मार्गदर्शन में स्पष्ट रूप से समोच्च का उपयोग करने का प्रयास किया गया, जो पैदल यात्री समोच्च के अनुप्रयोग की संभावना को काफी हद तक साबित करता है। यांग एट अल. [25] माना जाता है कि इस आधार पर कि किसी व्यक्ति के कपड़ों में परिवर्तन मजबूत नहीं है (मजबूत सर्दियों के कपड़ों और गर्मियों के कपड़ों के बीच के अंतर को संदर्भित करता है), पैदल यात्री रूपरेखा भी व्यक्तिगत विशेषताओं को अलग कर सकती है। इसके आधार पर, पैदल यात्री समोच्च मानचित्र का उपयोग क्रॉस-ड्रेसिंग व्यक्ति री-आईडी के लिए फीचर निष्कर्षण के इनपुट के रूप में किया जाता है, और अच्छे परिणाम प्राप्त होते हैं। यांग एट अल., चेन एट अल के शोध के आधार पर। [26] ध्यान तंत्र के साथ मिलकर, क्रॉस-ड्रेसिंग री-आईडी अनुसंधान के लिए पैदल यात्री समोच्च का उपयोग किया गया। हाल ही में जारी शोध [27] ने पैदल यात्री रंग छवि सुविधाओं और पैदल यात्री समोच्च सुविधाओं के बीच पारस्परिक जानकारी को अधिकतम करने के लिए एक बहु-स्तरीय उपस्थिति और समोच्च गहरी इन्फोमैक्स (एमएसी-डीआईएम) का प्रस्ताव दिया है, जो अधिक प्रभावी आकार-जागरूक सुविधा प्रतिनिधित्व को नियमित करने के लिए समोच्च सुविधा सीखने का उपयोग करता है। रंगीन छवियों से.
3. तरीके
इस खंड में, हम प्रस्तावित समोच्च सूचना निष्कर्षण मॉड्यूल (सीआईईएम) दिखाएंगे (जैसा कि चित्र 2 में दिखाया गया है), और समोच्च सूचना एम्बेडिंग के आधार पर री-आईडी विधि का विस्तृत विवरण देंगे (जैसा कि चित्र 3 में दिखाया गया है)।

3.1. कंटूर सूचना निष्कर्षण मॉड्यूल
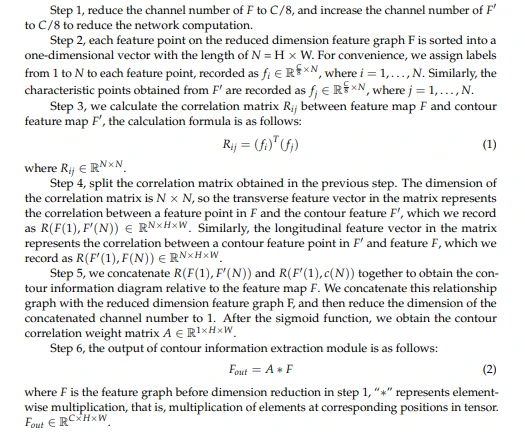
पैदल यात्री रूपरेखा में प्रासंगिक विशेषताएं शामिल हैं जो सीखने के लिए फायदेमंद हैं, लेकिन सामान्य सीएनएन नेटवर्क कुछ हद तक उन्हें अनदेखा कर देगा। नेटवर्क को पैदल यात्री समोच्च में निहित जानकारी पर अधिक ध्यान देने में सक्षम बनाने के लिए, हम ध्यान के विचार को अपनाते हैं और समोच्च सूचना निष्कर्षण मॉड्यूल का प्रस्ताव करते हैं। इसके बाद, हम समोच्च सूचना निष्कर्षण मॉड्यूल का विवरण पेश करेंगे और इसका उपयोग कैसे करें, जैसा कि चित्र 2 में दिखाया गया है।
डेटासेट में पैदल यात्री छवि के लिए, कनवल्शन के लिए ResNet-50 का उपयोग करते समय, अवशिष्ट परत के पीछे इसका आउटपुट फीचर मैप F के रूप में सेट किया गया है, और इसका आकार C x HW है, जहां C चैनलों की संख्या है और H x है W स्थान का आकार है. पैदल यात्री समोच्च शाखा के लिए, हम समोच्च सुविधा मानचित्र F' को फीचर मानचित्र F के समान आकार के साथ प्राप्त करने के लिए कनवल्शन परत के माध्यम से पैदल यात्री छवि के अनुरूप पैदल यात्री समोच्च मानचित्र के आयाम को कम करते हैं। इसका आकार 1 H x W है जहां 1 चैनल नंबर है. H x W स्थान का आकार है, और F और F' समोच्च सूचना निष्कर्षण मॉड्यूल के इनपुट हैं।
3.2. समग्र वास्तुकला
पिछले अनुभाग में, हमने समोच्च सूचना निष्कर्षण मॉड्यूल को विस्तार से पेश किया था। इसके बाद, हम समग्र रूप से समोच्च सूचना एम्बेडिंग के आधार पर री-आईडी विधि पेश करेंगे। हमारे द्वारा प्रस्तावित समग्र रूपरेखा चित्र 3 में दिखाई गई है।
पूरे फ़्रेम को क्रमशः दो इनपुट के साथ दो शाखाओं में विभाजित किया गया है। मुख्य शाखा का इनपुट डेटासेट में आरजीबी पैदल यात्री मूल छवि है, और समोच्च शाखा का इनपुट आरजीबी मूल छवि के अनुरूप पैदल यात्री समोच्च छवि है।
मुख्य शाखा में, हम ResNet-50 को बैकबोन नेटवर्क के रूप में उपयोग करते हैं, जिसे आम तौर पर पांच भागों में विभाजित किया जाता है, अर्थात् एक कनवल्शन परत conv1 और चार अवशिष्ट परतें।
समोच्च शाखा मुख्य रूप से पांच कनवल्शन परतों और चार समोच्च सूचना निष्कर्षण मॉड्यूल से बनी है। समोच्च मानचित्र के लिए प्रारंभिक आयामीता में कमी करने के लिए समोच्च परत के समान कनवल्शन परत के साथ एक कनवल्शन परत को समोच्च शाखा के सामने रखा जाता है। हम ResNet की प्रत्येक अवशिष्ट परत के आउटपुट स्थिति पर एक समोच्च सूचना निष्कर्षण मॉड्यूल जोड़ते हैं -50 और समोच्च सूचना निष्कर्षण मॉड्यूल से पहले एक कनवल्शन परत रखते हैं। कनवल्शन परत का इनपुट आयाम 1 है, आउटपुट आयाम 1 है, कर्नेल _ आकार=1 है, और चरण आकार 2 है, जिसका उपयोग समोच्च सुविधा मानचित्र के आयाम को कम करने के लिए किया जाता है।
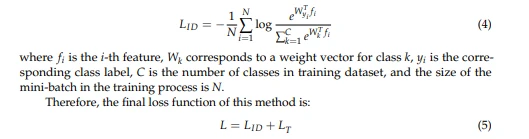
हमारे प्रयोग में प्रयुक्त प्रशिक्षण पद्धति वही है जो अधिकांश री-आईडी अध्ययनों में उपयोग की जाती है। प्रयोग में प्रयुक्त हानि फ़ंक्शन सॉफ्टमैक्स लॉस और हार्ड सैंपल माइनिंग (ट्राइहार्ड लॉस) [28] है, जिसे हम क्रमशः एलआईडी और एलटी के रूप में व्यक्त करते हैं। बैकबोन को विशेषता मानचित्र प्राप्त होने के बाद, यह एक औसत पूलिंग परत के माध्यम से विशेषता वेक्टर प्राप्त करता है। वेक्टर बीएन परत से गुजरने के बाद, यह हानि फ़ंक्शन एलटी की गणना करता है, और इसकी गणना सूत्र है:

जहां P एक बैच में व्यक्ति आईडी की संख्या का प्रतिनिधित्व करता है, प्रत्येक व्यक्ति आईडी के लिए यादृच्छिक रूप से K चित्रों का चयन करता है। ए एंकर बिंदु का प्रतिनिधित्व करता है, पी सकारात्मक नमूने का प्रतिनिधित्व करता है, और एन नकारात्मक नमूने का प्रतिनिधित्व करता है। A सकारात्मक नमूनों का सेट है और B नकारात्मक नमूनों का सेट है। maxda,p सबसे कठिन सकारात्मक नमूने का प्रतिनिधित्व करता है, और maxda,n सबसे कठिन नकारात्मक नमूने का प्रतिनिधित्व करता है। इसका मतलब मार्जिन है और इसे 0 पर सेट किया गया है।3.
हानि फ़ंक्शन एलआईडी की गणना रैखिक परत के माध्यम से बीएन परत आउटपुट से प्राप्त ईजेनवेक्टर द्वारा की जाती है, गणना सूत्र है:
4. प्रयोग
इस अध्याय में, हम प्रयोगात्मक परिणामों से प्रस्तावित विधि की प्रभावशीलता साबित करेंगे। इसलिए, हमने वशीकरण प्रयोगों की एक श्रृंखला तैयार की है। इस पेपर में विधि की सार्वभौमिकता को सत्यापित करने के लिए प्रस्तावित मॉडल का Market1501 और DukeMTMC-reID डेटासेट पर परीक्षण किया जाएगा। हाल के वर्षों में री-आईडी अनुसंधान में उन्नत तरीकों के साथ हमारी पद्धति की तुलना करने पर, हमारी पद्धति में अभी भी एक निश्चित प्रतिस्पर्धात्मकता है।
4.1. डेटासेट और कार्यान्वयन विवरण
हमने दो डेटासेट का चयन किया है जो प्रयोगों के लिए री-आईडी अनुसंधान में सबसे अधिक उपयोग किए जाते हैं। मार्केट1501 डेटासेट [29] में 1,501 विभिन्न पैदल यात्री आईडी, प्रशिक्षण सेट में 751 पैदल यात्री आईडी, और परीक्षण सेट में 750 पैदल यात्री आईडी, कुल 32,217 छवियां शामिल हैं। DukeMTMC-reID डेटासेट [30] में 1812 विभिन्न पैदल यात्री आईडी, प्रशिक्षण सेट में 702 पैदल यात्री आईडी और परीक्षण सेट में 1110 पैदल यात्री आईडी शामिल हैं। उनमें से, हम मुख्य रूप से Market1501 और DukeMTMC-reID डेटासेट के साथ एब्लेशन प्रयोग का उल्लेख करते हैं। प्रयोग में, हम डेटासेट के समोच्च को निकालने और पैदल यात्री समोच्च डेटासेट का निर्माण करने के लिए आरसीएफ मॉडल का उपयोग करते हैं।
नेटवर्क प्रशिक्षण से पहले, हम आरजीबी मूल छवियों और पैदल यात्री समोच्च छवियों पर डेटा एन्हांसमेंट ऑपरेशन करेंगे, जिसमें यादृच्छिक क्लिपिंग, क्षैतिज फ़्लिपिंग और अन्य सामान्य छवि एन्हांसमेंट ऑपरेशन शामिल होंगे, और विभिन्न डेटासेट को एकीकृत करने के लिए, हम इनपुट छवियों को 256 × 128 पिक्सेल पर समायोजित करेंगे। प्रशिक्षण प्रक्रिया में, हम सीखने की दर को 8 × 10⁻⁴, वजन क्षय दर को 5 × 10⁻⁴, प्रशिक्षण चक्र को 600 और बैच आकार को 32 पर सेट करने के लिए एडम ऑप्टिमाइज़र का उपयोग करते हैं। प्रशिक्षण के बाद, हमने सॉर्टिंग को अनुकूलित करने के लिए री-रैंकिंग जैसे तरीकों का उपयोग नहीं किया। परीक्षण चरण में, हमने प्रदर्शन का मूल्यांकन करने के लिए रैंक 1 और माध्य औसत परिशुद्धता (एमएपी) [29] की संचयी मिलान विशेषताओं (सीएमसी) [31] का उपयोग किया, जैसे कि री-आईडी पर अधिकांश शोध।
4.2. उच्छेदन अध्ययन
4.2.1. कंटूर सूचना की आवश्यकता
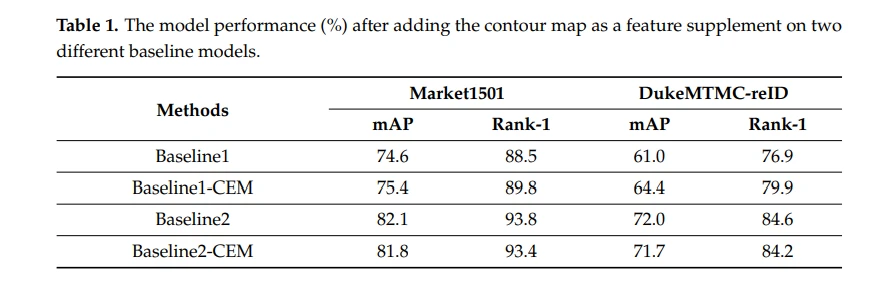
दो अलग-अलग बेसलाइन मॉडल में, हम सीधे पैदल यात्री समोच्च मानचित्र को नेटवर्क की मध्य परत में एम्बेड करने के लिए फीचर मानचित्र के रूप में उपयोग करते हैं और इसे समोच्च एम्बेडिंग विधि (सीईएम) नाम देते हैं। इन दो अलग-अलग बेसलाइन मॉडलों को बेसलाइन1 और बेसलाइन2 नाम दिया गया है। बेसलाइन1 एक कमजोर बेसलाइन मॉडल है, इसका बैकबोन नेटवर्क ResNet-50 है, और अंतिम अवशिष्ट परत का आयाम कटौती ऑपरेशन आरक्षित है। नेटवर्क प्रशिक्षण से पहले इमेजनेट पर पूर्व-प्रशिक्षित पैरामीटर का उपयोग करें। बेसलाइन 2 एक मजबूत बेसलाइन मॉडल है। इसका बैकबोन नेटवर्क ResNet-50 है, जो अंतिम अवशिष्ट परत के आयाम कटौती ऑपरेशन को हटा देता है। प्रशिक्षण से पहले, नेटवर्क पूर्व-प्रशिक्षित मापदंडों का उपयोग करता है जो री-आईडी अनुसंधान के लिए अधिक उपयुक्त हैं। विशिष्ट ऑपरेशन पैदल यात्री समोच्च मानचित्र को कनवल्शन परत के माध्यम से आयाम में कमी के बाद तत्व-स्तर के जोड़ के रास्ते में रेसनेट की चार अवशिष्ट परतों की आउटपुट स्थिति में एम्बेड करना है, यह सत्यापित करने के लिए कि सीएनएन नेटवर्क अनदेखा करता है छवि सुविधाओं को निकालने की प्रक्रिया में जानकारी का समोच्च करें। तालिका 1 हमारे कमजोर बेसलाइन1, बेसलाइन1-सीईएम, अधिक शक्तिशाली बेसलाइन2, और बेसलाइन2-सीईएम का प्रयोगात्मक डेटा दिखाती है, हम निम्नलिखित अवलोकन प्राप्त कर सकते हैं:
1. री-आईडी पर हमारे शोध में, सीएनएन नेटवर्क में समोच्च सुविधाओं के निष्कर्षण और समोच्च जानकारी की अभिव्यक्ति का अभाव है। इसे बेसलाइन1 और बेसलाइन1+सीईएम के बीच तुलना से देखा जा सकता है। हालाँकि अंतिम पहचान दर बहुत अधिक नहीं है, समोच्च मानचित्र जोड़ने का प्रभाव स्पष्ट है। उदाहरण के लिए, मार्केट1501 डेटासेट पर, सीईएम के साथ जोड़ा गया बेसलाइन1 मानचित्र पर 0.8% अधिक है और रैंक पर 1.3% अधिक है-1 मूल की तुलना में;
2. शक्तिशाली बेसलाइन 2 के लिए, शायद नेटवर्क पूर्व-प्रशिक्षित मापदंडों के अनुकूलन के कारण, सीईएम विधि नेटवर्क की अंतिम पहचान दर में सुधार नहीं कर सकती है, और सीधे समोच्च मानचित्र का उपयोग करने की विधि प्रभावी ढंग से सीएनएन नेटवर्क पर ध्यान नहीं दे सकती है अधिक समोच्च जानकारी के लिए, यह मूल पहचान प्रदर्शन को भी कम कर देगा। नेटवर्क को मजबूत आधार रेखा पर समोच्च जानकारी पर ध्यान देने के लिए, समोच्च सूचना निष्कर्षण मॉड्यूल प्रस्तावित है।
4.2.2. सीआईईएम जोड़ने के लिए स्थिति का चयन करें
मौजूदा कनवल्शनल न्यूरल नेटवर्क की विशेषताओं से, एक छवि में निहित किनारे, समोच्च और अन्य फीचर जानकारी सभी उथले फीचर अभिव्यक्ति हैं, और सीएनएन नेटवर्क की प्रत्येक परत के फीचर मैप के विज़ुअलाइज़ेशन परिणाम भी समान हैं। इसलिए, समोच्च सूचना निष्कर्षण मॉड्यूल को कहां रखा जाए और इसका उपयोग कैसे किया जाए, यह सत्यापित करने के लिए निम्नलिखित प्रयोगों की आवश्यकता है। हम ResNet की चार अवशिष्ट परतों के आउटपुट स्थानों पर समोच्च सूचना निष्कर्षण मॉड्यूल का उपयोग करेंगे, और इन चार स्थितियों को L4 नाम देंगे। प्रयोगात्मक परिणाम तालिका 2 में दिखाए गए हैं, और हम निम्नलिखित अवलोकन प्राप्त कर सकते हैं।

समोच्च सूचना निष्कर्षण मॉड्यूल का उपयोग करने की विधि प्रयोग से पहले की अटकलों से काफी अलग है। प्रयोगात्मक डेटा से, जब हम केवल पहले तीन अवशिष्ट परतों के बाद समोच्च सूचना निष्कर्षण मॉड्यूल जोड़ते हैं, तो प्रयोगात्मक परिणामों में सुधार स्पष्ट नहीं होता है। मार्केट1501 डेटासेट को एक उदाहरण के रूप में लेते हुए, एल1 और एल2 आउटपुट स्थानों पर उपयोग किए गए समोच्च सूचना निष्कर्षण मॉड्यूल की अंतिम रैंक 1 94.3% है, और एल1, एल2 और एल3 आउटपुट स्थानों पर उपयोग किए गए समोच्च सूचना निष्कर्षण मॉड्यूल की अंतिम रैंक 1 है। 94.5% है; इन दो तरीकों का मान्यता प्रभाव बेसलाइन मॉडल की तुलना में बेहतर है, लेकिन सुधार बड़ा नहीं है, और परिणाम समान हैं। जब चार अवशिष्ट परतों के बाद समोच्च सूचना निष्कर्षण मॉड्यूल का उपयोग किया जाता है, तो नेटवर्क का अंतिम मान्यता प्रभाव रैंक 1 पर 83.8% और मानचित्र पर 95.1% होता है, जो कि पिछले दो की तुलना में काफी सुधार हुआ है, और बेसलाइन मॉडल से भी अधिक है। उपयोग। इसलिए, हम इस लेख का अंतिम मॉडल आर्किटेक्चर प्राप्त करते हैं।
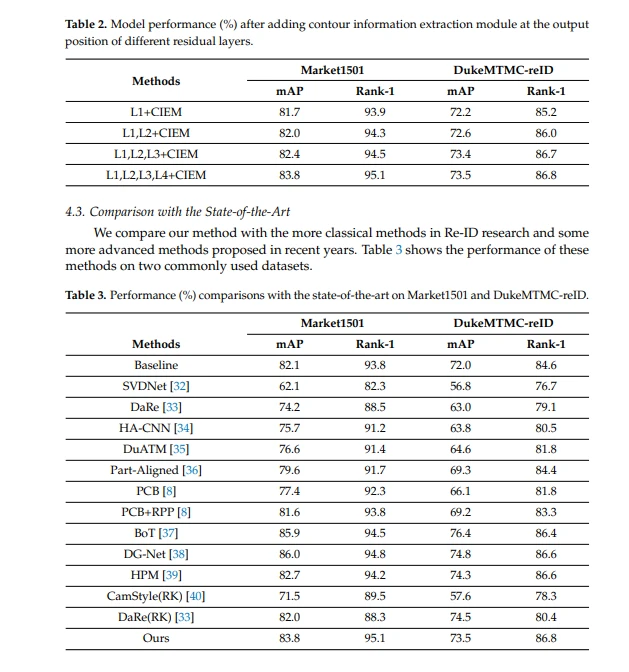
सबसे पहले, बेसलाइन मॉडल की तुलना में, हमारी पद्धति अभी भी एक बहुत शक्तिशाली बेसलाइन मॉडल पर अंतिम पहचान प्रभाव में सुधार कर सकती है; उदाहरण के तौर पर मार्केट1501 डेटासेट को लेते हुए, हमारी पद्धति एमएपी में बेसलाइन मॉडल से 1.7% अधिक है और रैंक-1 में बेसलाइन मॉडल से 1.3% अधिक है। इसके अलावा, एसवीडीनेट, पीसीबी इत्यादि जैसे शास्त्रीय री-आईडी एल्गोरिदम की तुलना में, हमारी विधि ने एक मजबूत प्रतिस्पर्धात्मक लाभ दिखाया है और एमएपी और रैंक -1 में पूर्ण लाभ है, दो आमतौर पर उपयोग किए जाने वाले संकेतक। हाल के वर्षों में प्रस्तावित कुछ और उन्नत तरीकों की तुलना में, हमारी पद्धति के कुछ हद तक फायदे हैं। डेटासेट Market1501 पर प्रासंगिक प्रयोगों में, हमारी पद्धति का सूचक रैंक -1 में एक निश्चित लाभ है, उदाहरण के लिए, BoT, DGNet और अन्य विधियों की तुलना में, हमारी पद्धति में अभी भी लगभग 0.5% का लाभ है। सूचक एमएपी के संदर्भ में, हमारी पद्धति अभी भी अधिकांश से तुलनीय है, लेकिन डीजी-नेट की तुलना में अभी भी एक निश्चित अंतर है। डेटासेट DukeMTMC-reID पर, इस पद्धति द्वारा प्रस्तुत परिणाम अभी भी वही हैं। मूल्यांकन सूचकांक रैंक -1 के संदर्भ में हमारी पद्धति के अन्य तरीकों की तुलना में कुछ फायदे हैं, लेकिन यह एमएपी के संदर्भ में संतोषजनक नहीं है, जो हमारे अगले शोध और सुधार की दिशा भी है। बाकी के लिए, हमारी पद्धति रीरैंकिंग तकनीक का उपयोग नहीं करती है, लेकिन कैम और डेयर जैसी रीरैंकिंग तकनीक का उपयोग करने वाली अन्य विधियों की तुलना में, हमारी पद्धति में अभी भी कुछ फायदे हैं।
प्र. 5। निष्कर्ष
इस पेपर में, हम समोच्च सूचना एम्बेडिंग के आधार पर एक री-आईडी विधि का प्रस्ताव करते हैं। ध्यान तंत्र के विचार और सीएनएन फीचर मानचित्र और समोच्च मानचित्र के बीच संबंध के साथ, समोच्च सूचना निष्कर्षण मॉड्यूल का निर्माण किया गया है। हम री-आईडी अनुसंधान में सबसे अधिक उपयोग किए जाने वाले रेसनेट का उपयोग बैकबोन नेटवर्क के रूप में करते हैं, और इसकी अवशिष्ट परत आउटपुट स्थिति में समोच्च सूचना निष्कर्षण मॉड्यूल का उपयोग करते हैं ताकि नेटवर्क समोच्च पर अधिक ध्यान दे सके। फीचर निष्कर्षण की प्रक्रिया में जानकारी। हमारी विधि एक सफलता है जो समोच्च जानकारी का उपयोग करने का प्रयास करती है, और यह अभी भी एक बहुत शक्तिशाली बेसलाइन नेटवर्क पर बहुत अच्छा पहचान प्रभाव प्राप्त कर सकती है। समोच्च जानकारी का उपयोग यहीं तक सीमित नहीं है, और हमें उम्मीद है कि पैदल यात्री पहचान के क्षेत्र में पैदल यात्री समोच्च पर और अधिक शोध होगा।
लेखक का योगदान:
संकल्पना, एचसी, और वाईजेड; कार्यप्रणाली, एचसी; सत्यापन, HC, YZ, और SW; औपचारिक विश्लेषण, एसडब्ल्यू; जांच, एसडब्ल्यू; संसाधन, YZ और SW; डेटा क्यूरेशन, एचसी; लेखन-मूल मसौदा तैयार करना, एचसी; लेखन-समीक्षा और संपादन, YZ और SW सभी लेखकों ने पांडुलिपि के प्रकाशित संस्करण को पढ़ लिया है और उससे सहमत हैं।
फंडिंग:
यह कार्य चीन के राष्ट्रीय प्राकृतिक विज्ञान फाउंडेशन (नंबर 61631009, नंबर 61771220), और चीन के राष्ट्रीय कुंजी अनुसंधान एवं विकास कार्यक्रम (नंबर 2017वाईएफबी1002900, नंबर 2017वाईएफबी0404800) द्वारा समर्थित है।
संस्थागत समीक्षा बोर्ड वक्तव्य:
लागू नहीं।
सूचित सहमति वक्तव्य:
लागू नहीं।
डेटा उपलब्धता विवरण:
लागू नहीं।

हितों का टकराव:
ऑथर ने किसी हित संघर्ष की घोषणा नहीं की है।
संदर्भ
1. हाँ, एम.; शेन, जे.; लिन, जी.; जियांग, टी.; होई, एस. डीप लर्निंग फॉर पर्सन री-आइडेंटिफिकेशन: ए सर्वे एंड आउटलुक। आईईईई ट्रांस. पैटर्न गुदा. मच. Intell. 2021, 44, 2872-2893। [क्रॉसरेफ] [पबमेड]
2. झांग, एल.; ली, डब्ल्यू.; यू, एल.; सन, एल.; निंग, एक्स. जीएमफेस: चेहरे की छवि प्रस्तुत करने के लिए एक स्पष्ट कार्य। 2021, 68, 102022 प्रदर्शित करता है। [क्रॉसरेफ]
3. नीउ, सी.; नान, एफ.; वांग, एक्स. 3DDFA और CBAM पर आधारित एक सुपर-रिज़ॉल्यूशन फ्रंटल फेस जेनरेशन मॉडल। 2021, 69, 102043 प्रदर्शित करता है। [क्रॉसरेफ]
4. रुआन, एलएच; हान, वाईएक्स; सन, जेआर; चेन, क्यूसी; ली, जेक्यू चेहरे की अभिव्यक्ति की पहचान चेहरे के रोड़ा परिदृश्यों में: एक पथ चयन मल्टी-नेटवर्क। 2022, 74, 102245 प्रदर्शित करता है। [क्रॉसरेफ]
5. चेन, किलोवाट; लाइ, सीसी; ली, पीजे; चेन, सीएस; हुआंग, वाईपी टारगेट ट्रैकिंग और मल्टीपल नॉन-ओवरलैपिंग कैमरों में ट्रू लिंकिंग की खोज के लिए अनुकूली शिक्षण। आईईईई ट्रांस. बहुगुणित। 2011, 13, 625-638। [क्रॉसरेफ]
6. खामिस, एस.; कुओ, सीएच; सिंह, वीके; शेट, वीडी; विशेषता-संगत व्यक्ति पुनः पहचान के लिए डेविस, एलएस संयुक्त शिक्षण। कंप्यूटर विज़न पर यूरोपीय सम्मेलन की कार्यवाही में, ज्यूरिख, स्विट्जरलैंड, 6-12 सितंबर 2014; पृ. 134-146.
7. यांग, एक्स.; वांग, एम.; ताओ, डी. विशेषाधिकार प्राप्त जानकारी का उपयोग करके मीट्रिक सीखने के साथ व्यक्ति की पुनः पहचान। आईईईई ट्रांस. छवि प्रक्रिया. 2018, 27, 791-805। [क्रॉसरेफ] [पबमेड]
8. सन, वाई.; झेंग, एल.; यांग, वाई.; तियान, क्यू.; वांग, एस. बियॉन्ड पार्ट मॉडल्स: रिफाइंड पार्ट पूलिंग के साथ पर्सन रिट्रीवल। कंप्यूटर विज़न पर यूरोपीय सम्मेलन की कार्यवाही में, म्यूनिख, जर्मनी, 8-14 सितंबर 2018; पीपी. 501-518.
9. झाओ, एच.; तियान, एम.; सन, एस.; जिंग, एस.; टैंग, एक्स. स्पिंडल नेट: मानव शरीर क्षेत्र निर्देशित फ़ीचर अपघटन और संलयन के साथ व्यक्ति की पुनः पहचान। कंप्यूटर विजन और पैटर्न रिकग्निशन (सीवीपीआर) पर 2017 आईईईई सम्मेलन की कार्यवाही में, होनोलूलू, एचआई, यूएसए, 21-26 जुलाई 2017; पीपी. 907-915.
10. झू, जे.; यांग, एच.; वांग, जे.; झांग, डब्ल्यू. विवरण-आधारित व्यक्ति बहु-दानेदार मिलान नेटवर्क के साथ खोज। 2021, 69, 102039 प्रदर्शित करता है। [क्रॉसरेफ]
11. गुओ, एन.; दी, के.; लियू, एच.; वांग, वाई.; क़ियाओ, जे. एक मीट्रिक-आधारित मेटा-लर्निंग दृष्टिकोण ने कुछ-शॉट सीखने के लिए ध्यान तंत्र और सामूहिक शिक्षण को संयोजित किया। डिस्प. तकनीक. आवेदन. 2021, 70, 102065। [क्रॉसरेफ]
12. गीरहोस, आर.; रुबिश, पी.; माइकलिस, सी.; बेथगे, एम.; विचमैन, एफए; ब्रेंडेल, डब्ल्यू. इमेजनेट-प्रशिक्षित सीएनएन बनावट के प्रति पक्षपाती हैं; आकार का पूर्वाग्रह बढ़ने से सटीकता और मजबूती में सुधार होता है। लर्निंग रिप्रेजेंटेशन पर अंतर्राष्ट्रीय सम्मेलन की कार्यवाही में, न्यू ऑरलियन्स, एलए, यूएसए, 6-9 मई 2019।
13. जियांग, जेड.; युआन, वाई.; वांग, क्यू. अनुकूली गहराई के माध्यम से सिमेंटिक विभाजन के लिए कंटूर-अवेयर नेटवर्क। न्यूरोकंप्यूटिंग 2018, 284, 27-35। [क्रॉसरेफ]
14. वेई, एक्सएल; हू, बाय; गाओ, टीएस; वांग, जे.; डेंग, बी. बनावट पहचान के लिए मल्टी-स्केल कनवल्शनल न्यूरल नेटवर्क। 2022, 75, 102324 प्रदर्शित करता है। [क्रॉसरेफ]
15. रु, हा; लेई, एमए; झा, बी.; एक्ससी, सी. टी-जीएएन: अनुकूली ग्राफ कनवल्शन और ध्यान तंत्र के साथ अस्थायी जटिल नेटवर्क की भविष्यवाणी के लिए एक गहन शिक्षण ढांचा। 2021, 68, 102023 प्रदर्शित करता है।
For more information:1950477648nn@gmail.com