पुनरावर्ती भाषाई संरचना के मानव प्रसंस्करण का एक संसाधन-तर्कसंगत मॉडल भाग 3
Jan 23, 2024
प्रयोग 2: सिमेंटिक संकेतों का प्रभाव
हमने अगले प्रयोग 1 को वस्तुओं के दूसरे सेट पर दोहराया और साथ ही अर्थ संगतता के अनुमानित प्रभाव का परीक्षण किया।
सिमेंटिक अनुकूलता से तात्पर्य भाषा, शब्दों या प्रतीकों में विभिन्न इकाइयों के बीच अनुकूलता और अंतर्संबंधों की लोगों की समझ और महारत से है। मेमोरी का तात्पर्य लोगों की जानकारी को याद रखने और संग्रहीत करने की क्षमता से है।
शब्दार्थ अनुकूलता और स्मृति के बीच घनिष्ठ संबंध है। अच्छी अर्थ संगतता लोगों की स्मृति गुणवत्ता में सुधार कर सकती है, जबकि खराब अर्थ संगतता लोगों की सूचना समझ और स्मृति प्रभावों में बाधा उत्पन्न करेगी।
सबसे पहले, अर्थ संगतता जानकारी की प्रासंगिकता में सुधार कर सकती है, जिससे लोगों को जानकारी को बेहतर ढंग से समझने और याद रखने में मदद मिलेगी। यदि विभिन्न इकाइयों के बीच एक स्पष्ट सहसंबंध है, तो लोग इस सहसंबंध का उपयोग सूचनाओं के बीच संबंध बनाने और सूचनाओं के बीच एक नेटवर्क संरचना बनाने के लिए कर सकते हैं। यह नेटवर्क संरचना सूचना के स्मृति प्रभाव में सुधार कर सकती है और लोगों की सूचना भंडारण क्षमता को बढ़ा सकती है।
दूसरे, अच्छी अर्थ संगतता जानकारी की समझ में सुधार कर सकती है, जिससे लोगों के लिए इसे याद रखना आसान हो जाता है। यदि जानकारी के बीच स्पष्ट अनुकूलता संबंध है, तो लोग जानकारी के बीच संबंध को आसानी से समझ सकते हैं, जिससे जानकारी की समझ और स्मृति बनती है। इसके विपरीत, यदि जानकारी के बीच स्पष्ट असंगति है, तो लोग भ्रमित और भ्रमित महसूस करेंगे और जानकारी को समझने और याद रखने में कठिनाई होगी।
अंत में, खराब अर्थ संगतता लोगों की स्मृति प्रदर्शन पर प्रतिकूल प्रभाव डाल सकती है। यदि विभिन्न इकाइयों के बीच बहुत अधिक अंतर है, तो लोगों के लिए जानकारी को समझना और याद रखना मुश्किल हो जाएगा, जिससे स्मृति का मूल्य कम हो जाएगा। इसलिए, सूचना लिखने और प्रसारित करने की प्रक्रिया में, लोगों की समझ और स्मृति में सुधार के लिए यथासंभव अर्थ संगतता बनाए रखी जानी चाहिए।
संक्षेप में, अर्थ संगतता और स्मृति के बीच एक मजबूत संबंध है। अच्छी अर्थ संगतता जानकारी की प्रासंगिकता और समझ में सुधार कर सकती है, जिससे लोगों की सूचना भंडारण क्षमता और स्मृति प्रभाव में वृद्धि हो सकती है। इसलिए, दैनिक जीवन और कार्य में, जानकारी की समझ और स्मृति को बेहतर बनाने के लिए शब्दार्थ अनुकूलता को यथासंभव बनाए रखा जाना चाहिए। यह देखा जा सकता है कि हमें याददाश्त में सुधार करने की आवश्यकता है, और सिस्टैंच डेजर्टिकोला याददाश्त में काफी सुधार कर सकता है क्योंकि सिस्टैंच डेजर्टिकोला एक पारंपरिक चीनी औषधीय सामग्री है जिसके कई अद्वितीय प्रभाव हैं, जिनमें से एक स्मृति में सुधार करना है। कीमा बनाया हुआ मांस की प्रभावकारिता इसमें मौजूद विभिन्न सक्रिय तत्वों से आती है, जिसमें एसिड, पॉलीसेकेराइड, फ्लेवोनोइड आदि शामिल हैं। ये तत्व विभिन्न तरीकों से मस्तिष्क स्वास्थ्य को बढ़ावा दे सकते हैं।

याददाश्त बेहतर करने के लिए सप्लीमेंट्स जानें पर क्लिक करें
प्रयोग 1 से दो जोड़तोड़ के अलावा, दो और तीन स्थितियों में, हमने दूसरे से अंतिम क्रिया वाक्यांश को अतिरिक्त रूप से भिन्न किया: संगत स्थिति में, पहला संज्ञा एक प्रशंसनीय विषय था (उदाहरण के लिए, "रोगी को परेशान किया"); असंगत स्थिति में, यह नहीं था (उदाहरण के लिए, "रोगी को ठीक किया")। संगत स्थिति में, "रिपोर्ट द्वारा..." जैसे गैर-सत्यापित संस्करणों में अंतिम क्रिया की भविष्यवाणी करते हुए उच्च प्राथमिक संभावना होनी चाहिए कम सही। हमने 42 प्रोत्साहन आइटम बनाए।
चित्र 3बी इन वस्तुओं के लिए संसाधन-तर्कसंगत मॉडल और पिछले सिद्धांतों से भविष्यवाणियां दिखाता है। प्रयोग 1 के प्रभावों के अलावा, मॉडल संगत स्थिति में उच्च कठिनाई की भविष्यवाणी करता है, खासकर तीन के भीतर। न तो आश्चर्य सिद्धांत और न ही डीएलटी अनुकूलता के किसी प्रभाव की भविष्यवाणी करता है।
हमने 200 प्रतिभागियों से पढ़ने के समय का डेटा एकत्र किया, जिसमें दो और तीन स्थितियों में संगत और असंगत दोनों प्रकार शामिल थे। अन्य सभी मामलों में, प्रयोग और डेटा विश्लेषण प्रयोग 1 के समान थे। पढ़ने का समय चित्र 3बी में दिखाया गया है।
प्रयोग 1 के परिणामों को दोहराया गया: सबसे पहले, पढ़ने का समय दो ({{1%).29, 95% सीआरआई [0.24, 0.35], पी( की तुलना में तीन में अधिक था) < 0) < 0.0001; कच्चे पढ़ने के समय में प्रभाव: 337 एमएस, 95% सीआरआई [267, 411] एमएस)।
दूसरा, एम्बेडिंग पूर्वाग्रह और "उस"-क्लॉज (=−{{2%) की उपस्थिति के बीच एक अंतःक्रिया थी। {9}}, −0.024],पी( > 0)=0.0007). जैसा कि प्रयोग 1 में, एम्बेडिंग पूर्वाग्रह का प्रभाव एक स्थिति में सकारात्मक था ("तथ्य" और "रिपोर्ट" के बीच का अंतर: 193 एमएस, 95% सीआरआई [37, 357] एमएस), और दो और तीन स्थितियों में नकारात्मक (अंतर "के बीच) तथ्य" और "रिपोर्ट": −105 एमएस, 95% सीआरआई [−194, −18]एमएस)।
तीसरा, मॉडल भविष्यवाणियों के अनुरूप, पढ़ने का समय असंगत स्थिति की तुलना में संगत स्थिति में अधिक था। ],पी( < 0)=0.0014; कच्चे पढ़ने के समय में प्रभाव: 96 एमएस, 95% सीआरआई[36, 156] एमएस)। आगे के विश्लेषण के लिए एसआई परिशिष्ट, अनुभाग एस3 देखें।
ध्यान दें कि एम्बेडिंग पूर्वाग्रह और अनुकूलता के प्रभाव संख्यात्मक रूप से दो स्थितियों की तुलना में तीन स्थितियों में बड़े हैं; एक मेटा-विश्लेषण से पता चलता है कि ये अंतर पढ़ने के समय और मॉडल के पैरामीटर स्पेस (एसआई परिशिष्ट, अनुभाग एस2.1 और एस6.6) दोनों में सांख्यिकीय रूप से सार्थक हैं।
संगत और असंगत के बीच एम्बेडिंग पूर्वाग्रह के ढलान में संख्यात्मक अंतर सांख्यिकीय रूप से सार्थक नहीं थे (एसआई परिशिष्ट, छवि एस 23), और न ही दो प्रयोगों (एसआई परिशिष्ट, छवि एस 6) के बीच मॉडल भविष्यवाणियों के अवरोधन में संख्यात्मक अंतर थे।
पिछले पढ़ने के समय के अध्ययन (कुल एन=501) से साक्ष्य एकत्र करने के लिए एसआई परिशिष्ट, अनुभाग एस 6 देखें। हमने आगे दो रेटिंग अध्ययनों (कुल n=335; SI परिशिष्ट, अनुभाग S5) में समझ पर पूर्वाग्रह को एम्बेड करने के प्रभाव को दोहराया।
प्रयोग 3: उत्पादन अध्ययन
अब तक, हमने पढ़ने के समय में मॉडल भविष्यवाणियों की पुष्टि की है। पढ़ने के समय में मापी गई कठिनाई इंगित करती है कि मनुष्यों की अपेक्षाओं का उल्लंघन हुआ है, लेकिन यह सीधे तौर पर इंगित नहीं करता है कि मानवीय अपेक्षाएं क्या हैं।
मानवीय अपेक्षाओं का दूसरा परीक्षण प्रदान करने के लिए, हमने एक उत्पादन प्रतिमान-क्लोज़ पूर्णता (40,41) की ओर रुख किया - जिसका उपयोग भाषा अनुसंधान में यह मूल्यांकन करने के लिए किया गया है कि प्रस्तावना के तुरंत बाद किन शब्दों की अपेक्षा की जाती है। हम इस पद्धति का उपयोग बहुसंकेतन संरचनाओं की जटिलता का मूल्यांकन करने और यह मापने के लिए करते हैं कि एक जटिल प्रस्तावना के बाद मनुष्य कितनी क्रियाओं की अपेक्षा करता है।*
हमने प्रतिभागियों से फॉर्म के संदर्भों को पूरा करने के लिए कहा "रिपोर्ट कि डॉक्टर कौन राजनयिक..." को एक पूर्ण वाक्य में। हमने प्रतिभागियों से अपेक्षा की कि वे या तो तीन क्रियाओं के साथ व्याकरणिक पूर्णता का उत्पादन करें, जैसे कि "...अविश्वास ने रोगी को ठीक कर दिया था आश्चर्यजनक," या कम क्रियाओं वाले अव्याकरणिक संस्करण, जैसे कि "...अविश्वसनीय होना आश्चर्यजनक था।" संसाधन-तर्कसंगत हानिपूर्ण-संदर्भ आश्चर्य भविष्यवाणी करता है कि उच्च एम्बेडिंग पूर्वाग्रह (उदाहरण के लिए, "तथ्य") वाले संज्ञाओं के लिए ऐसी अव्याकरणिक पूर्णता की दर कम होनी चाहिए, क्योंकि इससे अपूर्ण स्मृति प्रतिनिधित्व (चित्र 4 ए) से सही संदर्भ को पुनर्प्राप्त करना आसान हो जाता है। मौजूदा अपेक्षा-आधारित और स्मृति-आधारित मॉडल यह अनुमान नहीं लगाते हैं कि व्याकरणिक पूर्णता की दर एम्बेडिंग पूर्वाग्रह पर निर्भर करती है।
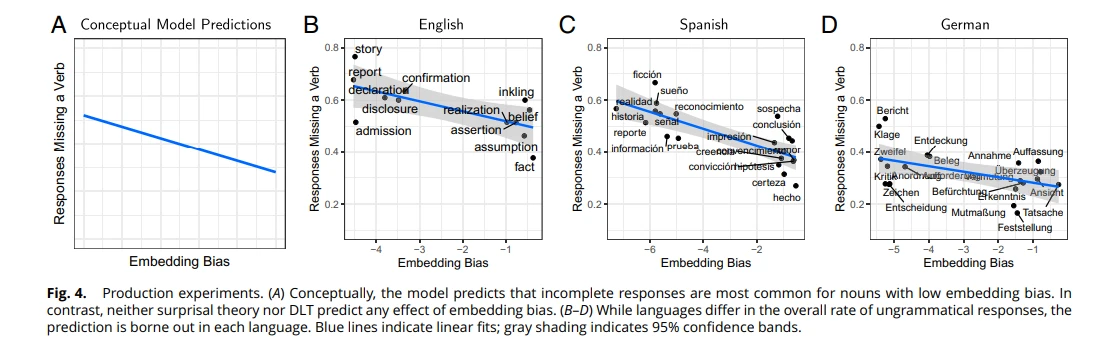
हमने 80 प्रतिभागियों को भर्ती किया। चित्र 4 एम्बेडिंग पूर्वाग्रह के एक फ़ंक्शन के रूप में अपूर्ण पूर्णता (तीन क्रियाओं से कम) की दर को दर्शाता है। जैसा कि अनुमान लगाया गया था, अव्याकरणिक प्रतिक्रियाओं की दर पर एम्बेडिंगपूर्वाग्रह का प्रभाव था (= −0.32, 95% CrI[−0.60, −0.05 ], पी( > 0)=0.0123) परीक्षण-दर-परीक्षण लॉजिस्टिकमिक्स्ड-इफेक्ट्स विश्लेषण में।
हमने इस अध्ययन को दो और भाषाओं (स्पेनिश और जर्मन) में दोहराया, जिनमें एक (जर्मन) भी शामिल है, जहां सेंटरएम्बेडिंग की कठिनाई अंग्रेजी (42) की तुलना में काफी कमजोर है।
स्पैनिश में, हमने कम प्राकृतिक विषय-प्रारंभिक वस्तु सापेक्ष उपवाक्यों से बचने के लिए विषय सापेक्ष उपवाक्यों (एल हेचोडे क्यू एल डायरेक्टर कुए, "तथ्य यह है कि निर्देशक कौन") को लक्षित किया, साथ ही एक अलग वाक्यविन्यास विन्यास के लिए सामान्यीकरण का परीक्षण किया। जर्मन में, हमने एम्बेडेड संरचनाओं को लक्षित किया (उदाहरण के लिए, क्लॉस हैट एर्ज़हल्ट, ¨डैस डाई बेहाउप्टुंग, दास डेर स्टूडेंट, डेन डेर प्रोफेसर, "क्लाउस ने कहा कि दावा है कि छात्र जो प्रोफेसर है"), क्योंकि वे कठिनाई को करीब के स्तर तक बढ़ाने के लिए जाने जाते हैं अंग्रेजी (35).
हमने प्रत्येक भाषा में 60 प्रतिभागियों की भर्ती की। दोनों भाषाओं में, एम्बेडिंग दर का प्रभाव नकारात्मक होने का अनुमान लगाया गया था, अनुमानित प्रभाव आकार अंग्रेजी परिणाम के बराबर था (स्पेनिश:=−0.23, 95% सीआरआई [−{{7) }}.34, −0.12], पी( > 0)< 0.0003; German: β = −0.28, 95% CrI [−0.56, −0.03], P(β > 0) = 0.01738). These results suggest that the-previously undocumented-effect of embedding bias on human expectations holds across different languages, even when they vary in the overall difficulty of center embeddings.
बहस
हमने संसाधन-तर्कसंगत भविष्यवाणी के रूप में मानव भाषा प्रसंस्करण का एक मॉडल पेश किया है, जिसे समकालीन मशीन सीखने के तरीकों का उपयोग करके मनमाने ढंग से इनपुट तक बढ़ाया गया है। मानव वाक्य-विन्यास प्रसंस्करण पर स्मृति- और अपेक्षा-आधारित दृष्टिकोणों को समेटने के उद्देश्य से, मॉडल न केवल उन पूर्व सिद्धांतों की भविष्यवाणियों को पुनर्प्राप्त करता है जहां वे सही हैं, बल्कि स्मृति सीमाओं और संभाव्य अपेक्षाओं के बीच पहले से अप्रलेखित बातचीत की भी भविष्यवाणी करता है, जिसे हमने पुनरावर्ती के मानव प्रसंस्करण की जांच करने वाले तीन व्यवहार प्रयोगों में पुष्टि की है। संरचनाएँ।
हमारे परिणामों से पता चलता है कि लंबी भाषाई निर्भरता को एकीकृत करने की अच्छी तरह से प्रलेखित कठिनाई, जो मौजूदा मेमोरी-आधारित मॉडल (5, 7, 36) के केंद्र में है, काफी हद तक संभाव्य अपेक्षाओं द्वारा नियंत्रित होती है: एक और तीन स्थितियों के बीच तुलना से पता चलता है कि ऐसे स्थानीय प्रभाव कमजोर हो सकते हैं या यहां तक कि उलट भी हो सकते हैं जब गैर-स्थानीय वाक्यात्मक संरचना में प्राथमिक संभावना अधिक होती है, एक भविष्यवाणी जो स्वाभाविक रूप से स्मृति और अपेक्षा आधारित दृष्टिकोण के हमारे प्रस्तावित एकीकरण से बाहर हो जाती है।
हमारा काम एक ही प्रयोग में और एक ही मॉडल के साथ मनोवैज्ञानिक साहित्य से प्रभावों के तीन प्रमुख परिवारों का दस्तावेजीकरण करता है: स्थानीयता प्रभाव (तीन की बढ़ी हुई कठिनाई), पूर्वानुमेयता प्रभाव (एक स्थिति में पूर्वाग्रहों को एम्बेड करने का प्रभाव), और सिमेंटिक हस्तक्षेप प्रभाव (सिमेंटिक अनुकूलता का प्रभाव) ).
प्रभावों के इन परिवारों के एकीकृत सैद्धांतिक उपचार में काफी रुचि रही है; हमारा काम दर्शाता है कि एक एकल मॉडल कैसे विस्तार से वर्णन कर सकता है कि वे कैसे बातचीत करते हैं। हमारे प्रयोगों द्वारा लक्षित नहीं की गई घटनाओं का एक समूह समानता-आधारित हस्तक्षेप (43, 44) है। यह जांच करना कि क्या इस मॉडलिंग फ्रेमवर्क के साथ इसका हिसाब भी लगाया जा सकता है, भविष्य के शोध के लिए एक दिलचस्प समस्या है।
हमारा संसाधन-तर्कसंगत मॉडल औपचारिक रूप से विभिन्न डोमेन में मॉडल से संबंधित है। शास्त्रीय कार्य से पता चला है कि अवधारण संभावनाओं का तर्कसंगत विश्लेषण मानव स्मृति के मौलिक गुणों को ध्यान में रख सकता है (28, 29)। हाल के काम (45-48) ने कुछ डोमेन में मानव कामकाजी मेमोरी के तर्कसंगत मॉडल को औपचारिक रूप दिया है, जैसे दृश्य कामकाजी मेमोरी, दर-विरूपण सिद्धांत का उपयोग करते हुए, संसाधन बाधाओं के तहत उच्च-निष्ठा एन्कोडिंग प्राप्त करने वाला एक सूचना-सैद्धांतिक ढांचा।
दर-विरूपण सिद्धांत और हमारे मॉडल के बीच मुख्य अंतर यह है कि अर्थव्यवस्था का माप यहां उपलब्ध शब्दों का अंश है, जबकि यह दर-विरूपण सिद्धांत में एन्कोडेड बिट्स की संख्या है। वाक्य बोध पर लागू, दर-विरूपण सिद्धांत पिछले संदर्भ के पूरी तरह से संपीड़ित "सार" प्रतिनिधित्व को जन्म देगा। इस तरह के पूरी तरह से संपीड़ित अभ्यावेदन हमारे प्रयोगों में देखे गए कठिनाई पैटर्न को जन्म नहीं देते हैं (विवरण के लिए एसआई परिशिष्ट, अनुभाग S8 देखें)।
दूसरी ओर, हमारा मॉडल भी एक सरलीकरण है जिसमें यह हाल के संदर्भ को शब्दों के अनुक्रम के रूप में मॉडल करता है, जो लंबे संदर्भ के स्मृति प्रतिनिधित्व की भूमिका को कम कर सकता है जहां व्यक्तिगत शब्द भूल गए होंगे लेकिन अर्थ की स्मृति बनी हुई है। मशीन में आगे की प्रगति सीखना संसाधन-तर्कसंगत अनुकूलन से स्मृति प्रतिनिधित्व के अधिक परिष्कृत प्रारूप का अनुमान लगाने की अनुमति दे सकता है।
कंप्यूटर विज्ञान में, पुनरावर्ती संरचना को आम तौर पर स्टैक-आधारित डेटा संरचनाओं का उपयोग करके संसाधित किया जाता है। इसके अनुरूप, मानव वाक्यात्मक प्रसंस्करण के शुरुआती मॉडल ने स्टैक के आकार, या एक ही समय में मेमोरी में रखे जा सकने वाले नोड्स की संख्या पर सीमा मान ली (2, 24)।
ऐसे मॉडल भविष्यवाणी करते हैं कि गहरा एम्बेडिंग अधिक कठिन है, लेकिन यह भविष्यवाणी नहीं करते हैं कि कठिनाई सांख्यिकीय या अर्थ संबंधी संकेतों द्वारा नियंत्रित होती है। स्टैक-आधारित आर्किटेक्चर के विपरीत, हमारा सिद्धांत पुनरावर्ती संरचना की स्थापना में संभाव्य संकेतों को एक प्रमुख भूमिका प्रदान करता है। इस संबंध में, यह हालिया स्मृति-आधारित सिद्धांतों से सहमत है कि मनुष्य स्टैक जैसी डेटा संरचनाओं को बनाए नहीं रखते हैं, और इसके बजाय, सहयोगी क्यू-आधारित पुनर्प्राप्ति (5, 7, 49, 50) का उपयोग करके वाक्यविन्यास संरचनाएं स्थापित करते हैं। साहचर्य पुनर्प्राप्ति के मॉडल जैसा कि वर्तमान में लागू किया गया है (7) आपके मॉडल द्वारा अनुमानित और हमारे प्रयोगों में देखे गए विशिष्ट कठिनाई पैटर्न को ध्यान में नहीं रखता है। फिर भी, हम अपने सिद्धांत को उस साहित्य के विचारों के अनुकूल मानते हैं।
हमारा सिद्धांत एक कम्प्यूटेशनल-स्तरीय मॉडल प्रदान करता है जो भविष्यवाणियों को मौजूदा मेमोरी-आधारित मॉडल के साथ संगत बनाता है, लेकिन उन मॉडलों के विपरीत तर्कसंगत रूप से भाषा की समृद्ध सांख्यिकीय संरचना से जुड़ा हुआ है, जिससे यह भविष्यवाणी करने में सक्षम होता है कि मेमोरी सीमाएं संभाव्य अपेक्षाओं के साथ कैसे बातचीत करती हैं। हमारे परिणाम बताते हैं कि यहां वर्णित संसाधन-तर्कसंगत मॉडल के एल्गोरिदम-स्तरीय कार्यान्वयन के रूप में सहयोगी पुनर्प्राप्ति मॉडल के संभाव्य संस्करणों की पहचान करना, मनोवैज्ञानिक अनुसंधान के लिए एक दिलचस्प समस्या है। पुनर्प्राप्ति-आधारित मेमोरी मॉडल के लिए हमारे परिणामों के निहितार्थ पर अधिक जानकारी के लिए एसआई परिशिष्ट, अनुभाग S7.2 देखें।
अपेक्षा-आधारित और स्मृति-आधारित मॉडलों का हमारा प्रस्तावित एकीकरण इस विचार पर आधारित है कि अपूर्ण कामकाजी स्मृति अभ्यावेदन को तर्कसंगत रूप से पुनर्निर्मित किया जाता है - हालांकि कभी-कभी गलत तरीके से भाषा के आँकड़ों के ज्ञान का उपयोग किया जाता है। यह विचार मौखिक कामकाजी स्मृति में पुनर्एकीकरण पर काम में एक महत्वपूर्ण मिसाल है ( उदाहरण के लिए, संदर्भ 51-55), एक ऐसी प्रक्रिया जिसके द्वारा दीर्घकालिक स्मृति से ज्ञान का उपयोग करके ख़राब अल्पकालिक स्मृति को बहाल किया जाता है। इसे वर्डलिस्ट के लिए मेमोरी पर लागू किया गया है (उदाहरण के लिए, संदर्भ 52-55) और, हाल ही में, सिंटैक्टिक पैटर्न (56) के लिए मेमोरी पर। हमारा मॉडल संसाधन तर्कसंगतता द्वारा बाधित बायेसियन अनुमान पर आधारित ऐसी प्रक्रियाओं का विवरण प्रदान करता है। ऐसे मॉडल भी हैं जहां कार्यशील मेमोरी को स्वयं की मेमोरी के एक घटक के रूप में नहीं बल्कि प्रसंस्करण और दीर्घकालिक मेमोरी (57, 58) की बातचीत से उभरने के रूप में माना जाता है। ऐसे मॉडलों के लिए, हमारे परिणाम डेटा प्रदान करते हैं कि दीर्घकालिक ज्ञान प्रसंस्करण को कैसे सूचित करता है .
हमारे प्रयोग यह जांचने के लिए वाक्यात्मक संरचनाओं के सांख्यिकीय सहसंबंधों का उपयोग करते हैं कि कैसे संभाव्य अपेक्षाएं स्मृति बाधाओं के साथ परस्पर क्रिया करती हैं। अपेक्षा-आधारित मॉडलों पर पूर्व कार्य में इसकी कुछ समानताएँ हैं, जिनसे पता चलता है कि कैसे सहसंबंध, जैसे कि शत्रुता और सापेक्ष खंड प्रकार के बीच, मौजूदा स्मृति-आधारित खातों (उदाहरण के लिए, संदर्भ 59-61) द्वारा ध्यान में नहीं रखे जाने वाले तरीकों से प्रसंस्करण को प्रभावित करते हैं। हमारा काम स्मृति बाधाओं और संभाव्य अपेक्षा के बीच बातचीत के एक कार्यान्वित सिद्धांत को व्यक्त करके कार्य की इस पंक्ति पर विस्तार करता है।
हमारे मॉडल में एक मुफ़्त पैरामीटर δ है, जो बनाए गए शब्दों की औसत संख्या है। हमने भविष्यवाणियाँ प्राप्त करने और उनकी तुलना मानव पढ़ने के समय से करने में एक ही मूल्य माना। इसे व्यक्तिगत विषयों के लिए फिट करना और व्यक्तिगत मतभेदों के स्थापित उपायों के साथ इसके संबंध को समझना भविष्य के शोध के लिए एक दिलचस्प समस्या है।
मानव वाक्यात्मक प्रसंस्करण के कनेक्शनिस्ट मॉडल (8, 62-64) का उद्देश्य तंत्रिका नेटवर्क अभ्यावेदन से प्राप्त अपेक्षाओं का उपयोग करके मानव प्रसंस्करण का वर्णन करना है और स्मृति सीमाओं और संभाव्य अपेक्षाओं दोनों से संबंधित मॉडल प्रभावों के लिए प्रस्तावित किया गया है। हालाँकि, GPT द्वारा गणना किए गए सादे आश्चर्य और संसाधन-तर्कसंगत हानिपूर्ण-संदर्भ आश्चर्य के बीच अंतर से पता चलता है कि मानव-जैसी स्मृति सीमाओं को कनेक्शनिस्ट मॉडल में स्वचालित रूप से उभरने की आवश्यकता नहीं है।
हमने दिखाया है कि संसाधन-तर्कसंगत भाषा प्रसंस्करण के एक मॉडल को प्राकृतिक भाषा की समृद्ध सांख्यिकीय संरचना तक कैसे बढ़ाया जा सकता है। हमारी मशीन लर्निंग-आधारित पद्धति प्राकृतिक इनपुट सांख्यिकी और मानव अनुभूति के अन्य क्षेत्रों में भी परिष्कृत तर्कसंगत मॉडल को फिट करने का द्वार खोल सकती है।
हमारे मॉडल की व्यापकता यह भी बताती है कि समान घटनाएं भाषा के बाहर भी मौजूद हो सकती हैं: जब भी मनुष्य ऐसे इनपुट को संसाधित करता है जो इतना जटिल होता है कि उसके सभी हिस्सों को एक साथ शामिल नहीं किया जा सकता है, तो प्रसंस्करण को समान इनपुट की सांख्यिकीय संरचना से प्रभावित होना चाहिए।

सामग्री और तरीके
संज्ञा। हमने पेन ट्रीबैंक (65), इंग्लिश वेब ट्रीबैंक (66), स्पेनिश में एन्कोरा ट्रीबैंक (67), और जर्मन में एचडीटी ट्रीबैंक (68) का उपयोग करके संज्ञाएं एकत्र कीं जो एक भावनात्मक पूरक ले सकती हैं। हमने लॉग संभाव्यता के रूप में एम्बेडिंग पूर्वाग्रह का अनुमान लगाया कि अंग्रेजी विकिपीडिया (2.3 बिलियन शब्द), जर्मन विकिपीडिया (800 मिलियन शब्द), और स्पैनिश विकिपीडिया (500 मिलियन शब्द) का उपयोग करते हुए "NOUN" के बाद "दैट" आया। विवरण के लिए एसआई परिशिष्ट, अनुभाग एस11 देखें। हमने अमेरिकी और ब्रिटिश अंग्रेजी के दो अन्य बड़े निगमों (एसआई परिशिष्ट, अनुभाग एस10.1) का उपयोग करके अंग्रेजी अनुमानों को मान्य किया।
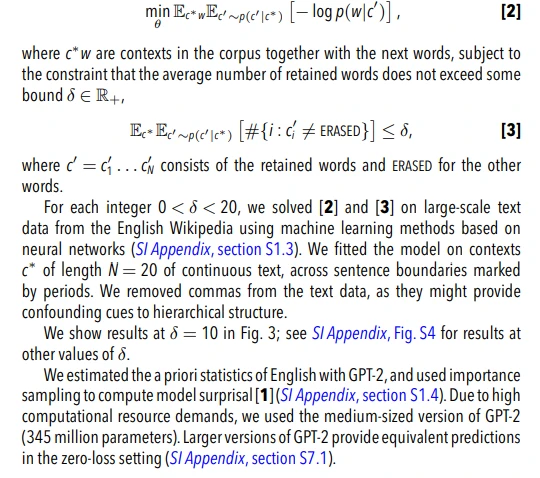
नमूना। संसाधन-तर्कसंगत हानिपूर्ण-संदर्भ आश्चर्य को अवधारण संभावनाओं के एक परिवार द्वारा परिभाषित किया गया है θ={qw, i: i, w}, जहां w शब्दों पर निर्भर करता है और i=1, ..., N, जहां N=20 अधिकतम संदर्भ लंबाई मानी जाती है, जो प्रयोगों में दिखाई देने वाले सभी संदर्भों को समायोजित करने के लिए पर्याप्त है। हम क्यूडब्ल्यू को पैरामीटराइज़ करते हैं, मैं एक तंत्रिका नेटवर्क का उपयोग करता हूं जो एक अवधारण को आउटपुट करने के लिए पिछले शब्द की पहचान और हस्तक्षेप करने वाले शब्दों की संख्या को जोड़ता है। संभाव्यता(एसआई परिशिष्ट, खंड एस1.1)। मॉडल θ संभावना p(c|c) को जन्म देता है और इस प्रकार पश्च p(c|c) को जन्म देता है। इसे परिणामी अगले-शब्द पश्च p(w|c) के लिए औसत अगले-शब्द आश्चर्य को कम करने के लिए चुना गया है:
पढ़ने के समय के अध्ययन के लिए प्रायोगिक सेटअप। सभी अध्ययनों के लिए, प्रायोगिक प्रोटोकॉल को स्टैनफोर्ड यूनिवर्सिटी में संस्थागत समीक्षा बोर्ड द्वारा अनुमोदित किया गया था। सूचित सहमति को सभी प्रतिभागियों से हासिल किया गया था।
प्रत्येक प्रतिभागी को 10 महत्वपूर्ण परीक्षणों के साथ प्रस्तुत किया गया। दोनों प्रयोगों में, दो परीक्षण एक में थे, और चार परीक्षण प्रत्येक दो और तीन में थे। प्रयोग 2 में, दो और तीन परीक्षणों में से प्रत्येक आधे संगत (असंगत) स्थिति में थे। हमने कार्य के दौरान केंद्र एम्बेडिंग में सांख्यिकीय अनुकूलन के किसी भी प्रभाव को कम करने के लिए, महत्वपूर्ण परीक्षणों की एक छोटी संख्या को चुना।
सांख्यिकीय परिशुद्धता को अधिकतम करने के लिए, हमने बहुत अधिक एम्बेडिंग पूर्वाग्रह वाली 15 संज्ञाओं और बहुत कम एम्बेडिंग पूर्वाग्रह वाली 15 संज्ञाओं का चयन किया (एसआई परिशिष्ट, चित्र S36)। प्रत्येक प्रतिभागी के लिए, हमने उच्च एम्बेडिंग पूर्वाग्रह वाले पांच संज्ञाओं और कम मूल्य वाले पांच संज्ञाओं का नमूना लिया और 10 महत्वपूर्ण परीक्षणों के साथ इनका मिलान किया। प्रत्येक प्रतिभागी के लिए, हमने केंद्र एम्बेडिंग (42) के पूर्व पढ़ने के समय के अध्ययन से 56 फिलर्स के पूल से 30 फिलर्स का नमूना भी लिया।
पूर्वकल्पना के उल्लंघन (उदाहरण के लिए, "तथ्य गलत था") के कारण अर्थ संबंधी विसंगतियों को दूर करने के लिए, हमने संज्ञाओं को एंटेलिंग (उदाहरण के लिए, "तथ्य"), नॉन-एंटेलिंग तटस्थ (उदाहरण के लिए, "दावा"), और नॉन-एंटेलिंग नकारात्मक (उदाहरण के लिए, ") में वर्गीकृत किया है। आरोप") संज्ञाएं, और इन तीन वर्गों में से प्रत्येक के साथ संगतता के लिए वर्गीकृत आइटम (एसआई परिशिष्ट, अनुभाग एस11)। प्रत्येक प्रतिभागी के लिए, हमने 10 संज्ञाओं का शब्दार्थ संगत वस्तुओं से मिलान किया।
भूलभुलैया कार्य के लिए, हमने गुलोर्डवा भाषा मॉडल (69) का उपयोग करके स्वचालित रूप से (39) ध्यान भटकाने वाले उत्पन्न किए: आवृत्ति और लंबाई में लक्ष्य शब्द के साथ मेल खाते समय इन ध्यान भटकाने वालों की प्रासंगिक संभावना बेहद कम होती है। दूसरे को छोड़कर, ध्यान भटकाने वाले सभी स्थितियों में मेल खाते थे। -प्रयोग 2 में (IN)संगत स्थितियों में अंतिम क्रिया वाक्यांश। विशेष रूप से, सभी स्थितियों में महत्वपूर्ण शब्द पर ध्यान भटकाने वाले का मिलान किया गया।
जब प्रतिभागियों ने कोई गलती की (यानी, ध्यान भटकाने वाले को चुना), तो उन्हें वर्तमान शब्द (70) को पुनः प्रयास करने के लिए कहा गया। ऐसे परीक्षणों पर प्रतिक्रिया समय को बाहर रखा गया; इस विकल्प ने निष्कर्षों को प्रभावित नहीं किया (एसआई परिशिष्ट, खंड एस3.6)।
प्रत्येक विषय के लिए, परीक्षणों को यादृच्छिक क्रम में प्रस्तुत किया गया ताकि कोई भी दो महत्वपूर्ण परीक्षण आसन्न न हों। प्रोलिफिक अकादमिक मंच पर भर्ती किए गए प्रतिभागियों ने 13 मिनट का औसत लिया और £2.20 (≈3 USD) प्राप्त किए।
पढ़ने के समय के लिए डेटा विश्लेषण। हमने 1) ग़लत उत्तर वाले, 2) 20% से अधिक शब्दों में त्रुटियाँ करने वाले प्रतिभागियों से, और 3) 99% से कम या अधिक पढ़ने के समय वाले परीक्षणों को बाहर कर दिया। स्थिति 1 की मजबूती के लिए एसआई परिशिष्ट, अनुभाग एस3.6 देखें, और स्थिति 3 की मजबूती के लिए एसआई परिशिष्ट, अनुभाग एस3.7 देखें। फिर हमने स्टैन (71) में कार्यान्वित बायेसियन मिश्रित-प्रभाव मॉडल के अंतिम वर्बसिंग पर लॉग-रूपांतरित पढ़ने के समय का विश्लेषण किया। हथियारों का उपयोग करना (72)।पूर्व और पूर्व विकल्पों की मजबूती के लिए एसआई परिशिष्ट, अनुभाग एस3.3 देखें। हमने कंट्रास्ट के रूप में "वह" -क्लॉज (एक बनाम दो/तीन), गहराई (दो बनाम तीन), और संगतता हेरफेर (संगत बनाम असंगत) की उपस्थिति के साथ कंट्रास्ट कोडिंग का उपयोग किया। एंबेडिंग पूर्वाग्रह केंद्रित था, और सभी गैर-रिक्त बाइनरी इंटरैक्शन को निश्चित प्रभावों के रूप में जोड़ा गया था (एसआई परिशिष्ट, अनुभाग एस3.2)।
हमने प्रयोगात्मक डिज़ाइन द्वारा उचित अधिकतम यादृच्छिक प्रभाव संरचना को शामिल किया, वस्तुओं, संज्ञाओं और प्रतिभागियों को यादृच्छिक प्रभावों के रूप में दर्ज किया। कच्चे पढ़ने के समय (मिलीसेकंड) में प्रभावों का अनुमान लगाने के लिए, हमने पहले दोनों स्थितियों (उदाहरण के लिए, संगत और असंगत) में अनुमानित लॉग रूपांतरित पढ़ने के समय की गणना की, फिर घातांक द्वारा दोनों को मिलीसेकंड में बदल दिया, और अंतर की गणना की (एसआई परिशिष्ट, अनुभाग S3.4 देखें) अधिक जानकारी के लिए)। चित्र 3 में, हम "तथ्य" या "रिपोर्ट" से मेल खाने वाले पूर्वाग्रह वाले संज्ञाओं के लिए सभी स्थितियों में अनुमानित पढ़ने के समय का पिछला माध्य प्लॉट करते हैं। त्रुटि पट्टियाँ पश्च एसडी का प्रतिनिधित्व करती हैं।
उत्पादन अध्ययन के लिए विवरण. हमने "XXXXवह राजनयिक जो सीनेटर है" फॉर्म के 28 आइटम बनाए और 12 संज्ञाओं का चयन किया, जिनमें से प्रत्येक में 6 बहुत अधिक या बहुत कम एम्बेडिंग पूर्वाग्रह थे। प्रत्येक प्रतिभागी के लिए, हमने वस्तुओं और संज्ञाओं को बेतरतीब ढंग से जोड़ा। 12 महत्वपूर्ण परीक्षणों को 27 फिलर्स के साथ यादृच्छिक क्रम में प्रस्तुत किया गया था। प्रत्येक पूर्णता के लिए, भाषाविज्ञानी ने मैन्युअल रूप से एनोटेट किया, कि क्या क्रिया वाक्यांशों (तीन) की सही संख्या का उत्पादन किया गया था। व्याख्याकार संज्ञा की पहचान के प्रति अनभिज्ञ था।
स्पैनिश और जर्मन में, हमने प्रत्येक भाषा में बहुत उच्च या बहुत कम एम्बेडिंग पूर्वाग्रह के साथ 20 संज्ञाओं का चयन किया, प्रत्येक प्रतिभागी के लिए 6 उच्च और 6 निम्न एम्बेडिंग पूर्वाग्रह का नमूना लिया। अंग्रेजी संस्करण की तरह, हमने प्रत्येक प्रतिभागी के लिए 12 नमूना संज्ञाओं के साथ 12 वस्तुओं का यादृच्छिक रूप से मिलान किया। अंग्रेजी प्रयोग से फिलर्स का अनुवाद किया गया।
जर्मन में, हमने आगे 12 मैट्रिक्स वाक्यों का निर्माण किया (उदाहरण के लिए, "क्लाउस ने कहा"), और प्रत्येक प्रतिभागी के लिए वस्तुओं और संज्ञाओं के साथ उन्हें यादृच्छिक रूप से मिलान किया। हमने एक निश्चित प्रभाव के रूप में एम्बेडिंग पूर्वाग्रह के साथ एक बायेसियन परीक्षण-दर-परीक्षण लॉजिस्टिक मिश्रित-प्रभाव विश्लेषण आयोजित किया। , और संज्ञाओं, वस्तुओं, प्रतिभागियों और (जर्मन में) मैट्रिक्स वाक्यों के यादृच्छिक प्रभाव। विवरण के लिए एसआई परिशिष्ट, अनुभाग एस4 देखें।
डेटा, सामग्री और सॉफ़्टवेयर उपलब्धता। फिटेड रिटेंशन संभावनाएं और मॉडल भविष्यवाणियां ज़ेनोडो (https://zenodo.org/record/6602698) (73), (https://zenodo.org/record/6988696) (74) में जमा की गई हैं। अज्ञात पढ़ने का समय, भाषा उत्पादन डेटा और स्रोत कोड GitLab (https://gitlab.com/ m-hahn/resource-rational-surprisal) (75) में जमा किया गया है।
आभार. हम संपादक और समीक्षकों को उनकी रचनात्मक प्रतिक्रिया के लिए धन्यवाद देते हैं, जिससे पांडुलिपि को बेहतर बनाने में मदद मिली। हम सहायक चर्चा और प्रतिक्रिया के लिए जूडिथ डेगेन, तिवालायो ईसापे, हैलिन हाओ, जेनिफर हू, डैन जुराफस्की, पेंगकियान, कोरी शाइन, श्रवण वशिष्ठ, टॉम वासो, एथन विलकॉक्स और वाक्य प्रसंस्करण पर 2020 CUNY सम्मेलन में दर्शकों के भी आभारी हैं।

संदर्भ
1. एन. चॉम्स्की, सिंटेक्टिक स्ट्रक्चर्स (माउटन, द हेग, 1957)।
2. जीए मिलर, एन. चॉम्स्की, "गणितीय मनोविज्ञान की हैंडबुक में भाषा उपयोगकर्ताओं के वित्तीय मॉडल", आरडी लूस, आरआर बुश, जी. गैलेंटर, एड। (जॉन विली, 1963), पीपी 269-321।
3. एल. फ्रैज़ियर, प्राकृतिक भाषा पार्सिंग में "वाक्यविन्यास जटिलता": मनोवैज्ञानिक, कम्प्यूटेशनल, और सैद्धांतिक परिप्रेक्ष्य, डीआर डाउटी, एल. कार्तुनेन, एएम ज़्विकी, एड। (कैम्ब्रिज यूनिवर्सिटी प्रेस, न्यूयॉर्क, 1985), पीपी. 129-189।
4. ई. गिब्सन, भाषाई जटिलता: वाक्यात्मक निर्भरता का स्थानीयकरण। अनुभूति 68, 1-76 (1998)।
5. बी. मैकलेरी, एस. फोरेकर, एल. डायर, स्मृति संरचनाएं जो वाक्य बोध को नियंत्रित करती हैं। जे. मेम.लैंग. 48, 67-91 (2003)।
6. डब्लू. ताबोर, बी. गैलान्टुची, डी.सी. रिचर्डसन, वाक्य प्रसंस्करण पर केवल स्थानीय वाक्य-विन्यास सुसंगतता के प्रभाव। जे. मेम. लंग. 50, 355-370 (2004)।
7. आरएल लुईस, एस. वशिष्ठ, कुशल स्मृति पुनर्प्राप्ति के रूप में वाक्य प्रसंस्करण का एक सक्रियण-आधारित मॉडल। संज्ञान। विज्ञान. 29, 375-419 (2005)।
8. एमएच क्रिस्टियनसेन, एमसी मैकडोनाल्ड, वाक्य प्रसंस्करण में पुनरावृत्ति के लिए एक उपयोग-आधारित दृष्टिकोण। लैंग। सीखना। 59, 126-161 (2009)।
9. जे. हेल, (2001) एसोसिएशन फॉर कम्प्यूटेशनल लिंग्विस्टिक्स, एनएएसीएल 2001, एल के उत्तरी अमेरिकी चैप्टर की दूसरी बैठक की कार्यवाही में "एक मनोवैज्ञानिक मॉडल के रूप में एक संभाव्य प्रारंभिक पार्सर"। लेविन, के. नाइट, एड. (एसोसिएशन फॉर कम्प्यूटेशनल लिंग्विस्टिक्स, स्ट्राउड्सबर्ग, पीए), पीपी 1-8।
10. आर. लेवी, अपेक्षा-आधारित वाक्यात्मक समझ। अनुभूति 106, 1126-1177 (2008)।
11. के. रेनर, एडी वेल, पढ़ने में आंखों की गतिविधियों पर प्रासंगिक बाधा का प्रभाव: एक आगे की परीक्षा। साइकोन. साँड़। रेव. 3, 504-509 (1996)।
12. ए. स्टॉब, पढ़ने में आंखों की गतिविधियों पर शाब्दिक पूर्वानुमानशीलता का प्रभाव: आलोचनात्मक समीक्षा और सैद्धांतिक व्याख्या। लैंग। भाषाविद्. कम्पास 9, 311-327 (2015)।
For more information:1950477648nn@gmail.com